Como a IA busca informação: RAG, grounding e o impacto no SEO
- Nível: Avançado
- #AI Search
- #GEO
- #Avançado
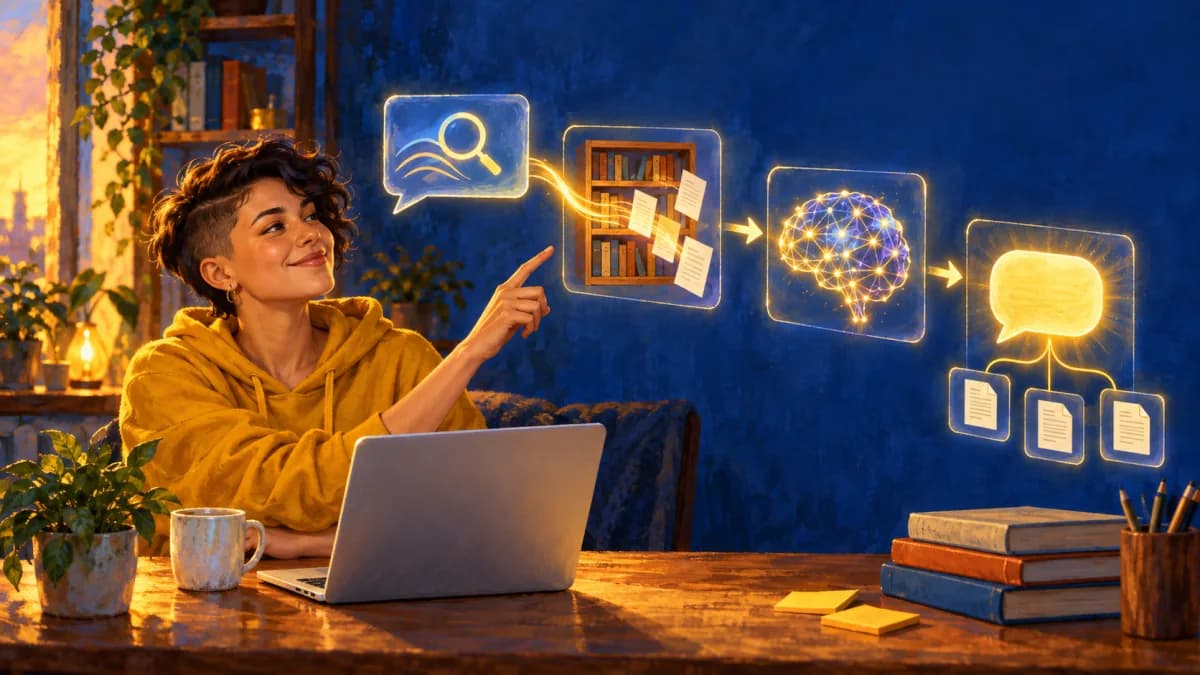
Um assistente de IA responde de duas formas: de memória, com o que aprendeu no treino, ou consultando fontes na hora. RAG (geração aumentada por recuperação) e grounding são os nomes técnicos da segunda forma: o sistema busca páginas, seleciona trechos e o modelo escreve a resposta apoiada neles. Para o SEO, isso significa que ser rastreável, indexável e claro em trechos importa, como explicamos em SEO, AEO e GEO.
Resumo rápido
- Treino é memória fixa, com data de corte. Recuperação é consulta ao vivo a uma base de documentos ou à web. As citações que você vê vêm da recuperação.
- O Google descreve RAG como a técnica (também chamada de grounding) em que o modelo usa páginas recuperadas do índice de busca para gerar a resposta e mostrar links.
- Uma pergunta pode virar várias buscas (query fan-out). Sua página pode ser recuperada por uma subpergunta que você nunca mirou.
- Como cada empresa seleciona e ranqueia trechos não é público. O que dá para fazer é cuidar do que é verificável: acesso, indexação, clareza e frescor.
- Para o Google, não há marcação nem arquivo especial para entrar nas respostas de IA, e a citação nunca é garantida.
Como ler: se você é leigo, leia "Qual a diferença entre treino e busca?" e "Como a pergunta vira resposta?", e pule os callouts técnicos. Se já trabalha com SEO, vá ao fan-out, à seção sobre trechos e à tabela de implicações.
Qual a diferença entre o que a IA aprendeu no treino e o que ela busca?
No treino, o modelo absorve padrões de uma enorme massa de texto e guarda isso nos seus parâmetros, sem acesso a páginas novas. Na recuperação, o sistema consulta uma fonte externa no momento da pergunta e entrega os resultados ao modelo, que os usa para responder. A segunda forma é a que permite citar fontes e falar de coisas recentes.
A ideia vem de um trabalho acadêmico. O artigo Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, de Patrick Lewis e colegas (publicado em 2020 e aceito na conferência NeurIPS), combinou memória paramétrica de um modelo de linguagem com uma memória externa, no caso um índice denso da Wikipédia, e mostrou melhoria em tarefas que exigem conhecimento. Hoje, a documentação de produtos como o Gemini descreve o mesmo princípio: o recurso de grounding com Google Search conecta o modelo a conteúdo da web em tempo real, para dar respostas além da data de corte do conhecimento e com citações.
Em linguagem simples: treino é a prova que você faz de cabeça, só com o que estudou. Recuperação é a prova com consulta: você abre o livro, acha o capítulo certo e responde olhando para ele. Grounding é a regra de que a resposta precisa apontar para a página do livro onde você achou a informação.
A consequência para o marketing é direta. Entrar no treino de um modelo você praticamente não controla. Entrar na recuperação depende do que você controla hoje: a página ser acessível, ser encontrada para a subpergunta certa e ter um trecho que responda.
O que é RAG e o que é grounding?
RAG é a técnica de buscar documentos relevantes e dá-los ao modelo antes de ele responder. Grounding é o objetivo: ancorar a resposta em fontes verificáveis. O Google trata os dois como equivalentes. No guia de otimização para recursos generativos, define RAG (também conhecido como grounding) como a técnica que melhora qualidade, precisão e atualização das respostas, apoiando-se nos sistemas de ranqueamento da Busca para recuperar páginas do índice e mostrar links que sustentam a informação.
Na prática, isso explica por que a página precisa estar indexada e elegível a snippet: os recursos generativos têm raiz nos sistemas de ranqueamento e qualidade que já existiam.
Para quem já trabalha com SEO: "RAG" é uma arquitetura, não um produto. Cada empresa decide o índice (próprio ou de terceiros), o número de documentos recuperados, o tamanho dos trechos, o reranqueamento e como a citação é anexada. Só as partes documentadas publicamente são citáveis. Nas demais, o que existe é inferência a partir de testes.
Como a pergunta vira resposta?
O caminho tem cinco etapas. As documentações oficiais confirmam as de decisão, busca e citação; a seleção e o reranqueamento de trechos as empresas não detalham.
- O sistema decide se precisa buscar. Pela documentação de web search da Anthropic, o Claude busca quando o pedido envolve algo atual, mutável ou fora do treino, e responde direto quando é conhecimento estável. No Gemini, o modelo analisa o pedido e determina se uma busca melhora a resposta.
- Gera uma ou várias consultas. O modelo reformula a pergunta em buscas que o sistema executa. A mesma documentação da Anthropic diz que o processo pode se repetir várias vezes em um mesmo pedido, e que perguntas factuais simples costumam usar de 1 a 3 buscas, enquanto pesquisas comparativas podem usar 10 ou mais.
- Recupera candidatos de um índice. Pode ser o índice do Google (no Gemini e nos recursos de IA da Busca) ou outro. Nem toda empresa informa qual índice usa.
- Seleciona os trechos úteis. Aqui entram técnicas gerais de RAG, como embeddings e reranqueamento. Não há documentação pública, por empresa, de pesos ou critérios.
- Escreve a resposta com citações. No caso da Anthropic, cada citação traz URL, título e até 150 caracteres do texto citado. No Gemini, as citações vêm como anotações que ligam partes do texto às fontes.
Repare que a citação é por trecho: a resposta aponta para uma passagem específica, não para "o site". Uma página boa, mas com a resposta enterrada, tende a perder para uma média com a resposta bem posicionada em um bloco claro.
O que é query fan-out e por que isso muda a pesquisa de palavras-chave?
Query fan-out é o conjunto de buscas relacionadas que o modelo gera ao mesmo tempo para reunir mais informação. O Google dá um exemplo em seu guia: para "como consertar um gramado cheio de ervas daninhas", o fan-out pode incluir "melhores herbicidas para gramado", "remover ervas daninhas sem produtos químicos" e "como prevenir ervas daninhas no gramado". Esse é o motivo pelo qual uma única pergunta pode recuperar páginas muito diferentes.
Para a pesquisa de palavras-chave, a lição é cobrir subtópicos que uma pessoa precisaria resolver, e não só a palavra principal. Detalhamos a mecânica em query fan-out.
Há um limite que o próprio Google coloca: criar uma página para cada variação de pergunta, principalmente para manipular respostas, viola a política de spam de conteúdo em escala. Cubra os subtópicos dentro de páginas úteis, em vez de gerar centenas de páginas quase iguais.
Exemplo hipotético: alguém pergunta "qual o melhor sistema de gestão para clínica pequena que emita nota fiscal?". O sistema poderia gerar subconsultas como "sistema de gestão para clínica pequena", "emissão de NFS-e em sistema de clínica", "preço de sistema para clínica" e "integração com convênios". Uma empresa com uma página específica sobre emissão de nota fiscal, com a resposta num bloco curto no início e a data de atualização, pode ser a fonte da segunda subconsulta mesmo sem ranquear para a pergunta completa. É uma ilustração, não um registro real de consultas.
Como a IA escolhe quais trechos usar?
Ninguém de fora sabe com precisão. O que existe de documentado é que o Google tem um sistema de ranqueamento de passagens, descrito no guia de sistemas de ranqueamento como um sistema de IA usado para identificar seções individuais ("passagens") de uma página e entender melhor sua relevância para a busca. Para os assistentes em geral, a descrição técnica comum é cortar documentos em trechos, convertê-los em vetores (embeddings), comparar com a consulta e, às vezes, reranquear os melhores.
Em linguagem simples: imagine que sua página é um livro e a IA tem pouco tempo. Ela não lê o livro todo, procura o parágrafo que responde. Se cada seção abre com a resposta, ela acha rápido. Se a resposta está espalhada em cinco parágrafos, é fácil passar para o livro do lado.
Há uma tensão aqui. O Google afirma, no mesmo guia, que não é preciso fragmentar o conteúdo em pedaços minúsculos para a IA, porque seus sistemas entendem vários tópicos numa página e mostram a parte relevante. Ou seja, nada de "chunking" artificial. Mas seções com título claro e resposta direta ajudam o leitor e não custam nada. Detalhamos isso em estrutura de conteúdo citável por LLM.
O que muda para o SEO na prática?
Muda a ênfase, não o fundamento. A tabela separa o que é documentado do que é boa prática.
| Aspecto | O que se sabe | O que fazer |
|---|---|---|
| Elegibilidade no Google | A página precisa estar indexada e elegível a snippet; o site também precisa estar incluído no controle de IA generativa do Search Console | Cheque indexação e o controle nas configurações do Search Console |
| Crawlers de IA | A OpenAI documenta o OAI-SearchBot (aparecer na busca do ChatGPT), o GPTBot (treino) e o ChatGPT-User (ações do usuário) | Defina no robots.txt quem pode acessar o quê; veja robots.txt e crawlers de IA |
| Frescor | A API de busca da Anthropic devolve um campo page_age por resultado | Mantenha data de atualização visível e revise dados que mudam |
| Citação por trecho | Citações apontam para passagens (até 150 caracteres citados no caso da Anthropic) | Abra cada seção com a resposta direta |
| Cobertura de subtópicos | O fan-out recupera páginas por subperguntas | Responda as subperguntas centrais, sem criar páginas quase duplicadas |
| Outros índices | Cada assistente usa índice próprio ou de terceiros e nem sempre informa qual | Cubra também Bing e IndexNow; veja Bing Webmaster e IndexNow para IA |
A documentação da OpenAI sobre seus crawlers traz três detalhes: sites que bloqueiam o OAI-SearchBot não aparecem nas respostas da busca do ChatGPT; bloquear o GPTBot indica que o conteúdo não deve ser usado no treino; e um ajuste no robots.txt pode levar cerca de 24 horas para valer. São decisões separadas: dá para aparecer na busca e negar o treino.
Para quem já trabalha com SEO: o ChatGPT-User, segundo a OpenAI, não é usado para rastrear a web de forma automática, e as regras do robots.txt podem não se aplicar a ele por ser acionado pelo usuário. Quem audita logs deve separar esses três agentes nas análises, em vez de tratar "tráfego de bots de IA" como um bloco único.
Como auditar uma página pensando em RAG?
Audite na ordem do pipeline. Cada passo é uma etapa em que a página pode ser eliminada antes de a resposta ser escrita.
- Acesso. O robots.txt e as regras de servidor permitem os crawlers que importam para você? Revise bloqueios por engano.
- Indexação. A página está indexada e sem
noindex? Confirme no Search Console com a inspeção de URL. - Cobertura. Liste de 5 a 10 subperguntas que uma pessoa teria sobre o tema e verifique se a página, ou o cluster, as responde.
- Trecho. Reescreva as aberturas das seções com a resposta primeiro, em 40 a 70 palavras.
- Frescor. Atualize dados, preços e datas, e mostre a data da última revisão.
- Teste. Faça as perguntas em dois ou três assistentes, anote quais fontes aparecem e o que está faltando na sua página em relação às citadas. Repita todo mês. O AI Visibility da Contentor acompanha, nas perguntas que você escolher, se o ChatGPT cita sua marca (somente ChatGPT).
Para um fluxo mais amplo de otimização, veja SEO para AI Search.
Perguntas frequentes
O que é RAG, em uma frase?
RAG é a técnica em que o sistema busca documentos relevantes e os entrega ao modelo antes de ele responder, para que a resposta use informação atual e possa citar fontes. O nome vem de um artigo de 2020. O Google usa o termo como sinônimo de grounding nas respostas de IA da Busca.
Preciso me preocupar com o treino dos modelos ou só com a busca?
Para visibilidade imediata, a busca é o que você controla: acesso, indexação e clareza dos trechos. Sobre o treino, você pode decidir se permite ou não o uso do conteúdo, por exemplo com o GPTBot no robots.txt, no caso da OpenAI. É uma decisão estratégica separada, e bloquear o treino não impede aparecer em respostas por busca.
Dividir o texto em blocos curtos ajuda a IA?
Ajuda o leitor e pode ajudar a extração, mas o Google diz que não é necessário fragmentar o conteúdo só para a IA. O melhor critério é a utilidade: seções com título claro e resposta direta funcionam para pessoas e para sistemas de recuperação.
O RAG garante que a resposta da IA está correta?
Não. O RAG melhora a chance de a resposta se apoiar em fontes, mas o modelo ainda pode interpretar mal um trecho ou citar uma fonte que não sustenta a afirmação. Por isso, ao testar sua marca, abra os links citados e confira se o trecho realmente diz o que a resposta afirma.
Próximo passo
Se você ainda não conferiu o acesso dos crawlers, comece por robots.txt e crawlers de IA, depois escreva trechos extraíveis com estrutura de conteúdo citável por LLM. Para o passo seguinte do caminho avançado, siga para a auditoria GEO passo a passo. Se o seu gargalo é produzir as páginas que respondem às subperguntas, gere artigos com IA na Contentor com títulos em forma de pergunta e resposta direta.
Leia também:
Prepare seu conteúdo para respostas de IA
Crie briefings AEO/GEO, entidades, schema e artigos estruturados para Google AI Overviews, AI Mode e SEO tradicional.
Testar o Contentor grátisFortaleça sua autoridade para AI Search
Combine conteúdo citável com backlinks contextuais em sites verificados para reforçar confiança, descoberta e autoridade temática.
Ver backlinks contextuais