Como o Google funciona: rastrear, indexar e ranquear
- Nível: Iniciante
- #SEO
- #Google Search Console
- #Iniciantes
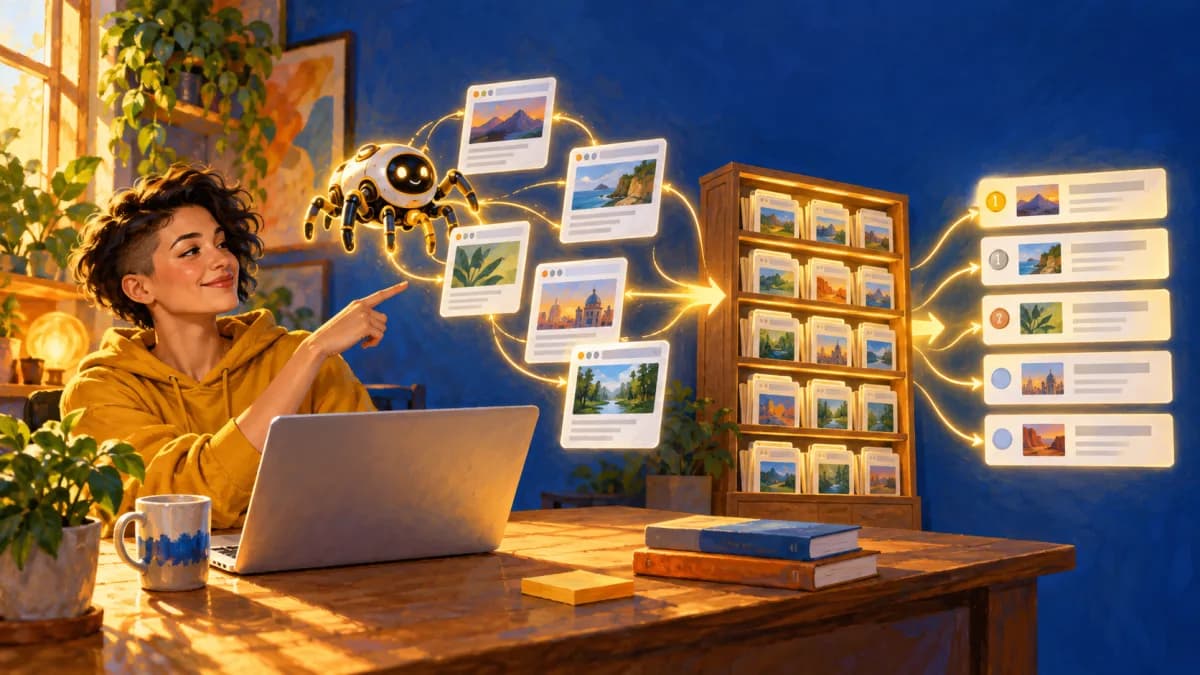
O Google funciona em três etapas: rastreia (um programa chamado Googlebot descobre e baixa páginas), indexa (analisa o conteúdo e o guarda em um banco de dados) e serve resultados (escolhe, a cada busca, o que mostrar e em que ordem). Uma página só aparece se passar pelas três, e cada etapa tem causas próprias de falha.
Este guia faz parte do guia completo de SEO e responde à pergunta que mais trava iniciantes: "publiquei e não aparece, por quê?". Ao final, você terá um passo a passo para diagnosticar, usando uma ferramenta gratuita do Google.
Resumo rápido
- Rastrear é descobrir e baixar a página. O Google chega a ela seguindo links, revisitando páginas conhecidas ou lendo sitemaps.
- Indexar é analisar e guardar. Nem toda página rastreada é indexada, e o Google avisa que a indexação não é garantida.
- Ranquear (servir resultados) é escolher, na hora da busca, as páginas mais relevantes do índice. Não dá para pagar para subir.
- O Google renderiza o JavaScript das páginas com uma versão recente do Chrome, mas isso acontece depois do rastreamento e pode demorar.
- Para saber em que etapa a sua página parou, use a Inspeção de URL e o relatório de indexação do Search Console.
Como ler: se você é leigo, leia as três primeiras seções e vá direto ao passo a passo de diagnóstico. Se já trabalha com SEO, concentre-se nos blocos "Para quem já trabalha com SEO", na tabela de status e nas notas sobre renderização e limites de tamanho.
Como o Google funciona, em três etapas?
O Google funciona como uma cadeia: primeiro encontra páginas, depois as entende e guarda, e só então decide quais mostrar. Quem se lembra dessa ordem consegue localizar o problema com rapidez, porque cada etapa deixa pistas diferentes.
Em linguagem simples: imagine um guia turístico que mapeia uma cidade. Primeiro, uma equipe de campo percorre as ruas e anota os endereços (rastrear). Depois, essas anotações viram um catálogo organizado por tema (indexar). Quando um turista pergunta "onde tem pizza boa aqui?", o guia consulta o catálogo e responde com as opções mais úteis para aquela pessoa (ranquear). Se a rua não aparece no mapa, nenhuma pizzaria dela entra no catálogo.
Essa estrutura vem da documentação oficial Como funciona a Busca do Google. Na prática: antes de mexer em título ou palavra-chave, confirme que a página foi rastreada e indexada. Nenhum ajuste de conteúdo ajuda uma página que o Google nunca guardou.
O que é rastrear (crawling)?
Rastrear é o Google descobrir que uma URL existe e baixar o conteúdo dela. Isso é feito pelo Googlebot, um conjunto de programas automáticos. Ele descobre páginas de três formas: revisitando páginas que já conhece, seguindo links de uma página para outra e lendo sitemaps enviados pelo dono do site.
O Googlebot tem dois "modos": o Googlebot Smartphone, que simula um celular, e o Googlebot Desktop. Segundo a documentação do Googlebot, os dois compartilham o mesmo token no robots.txt, então não dá para bloquear só um deles por esse arquivo.
O que atrapalha o rastreamento:
- Nenhum link aponta para a página. Uma página "órfã", que não recebe link de nenhuma outra, só é achada se estiver no sitemap. Por isso os links internos fazem parte do SEO, e não só da navegação.
- O robots.txt bloqueia a URL. O arquivo diz ao Googlebot onde ele não deve entrar.
- O servidor não responde bem. Erros do tipo 5xx e lentidão fazem o Google reduzir o ritmo.
- O link não é um link de verdade. Menus feitos só com JavaScript, sem o elemento
<a href>, podem não ser seguidos.
Para quem já trabalha com SEO: a documentação do Googlebot informa que ele rastreia os primeiros 2 MB de um arquivo de tipo suportado (64 MB no caso de PDFs) e que, ao atingir o limite, interrompe o download e envia apenas o trecho baixado para a indexação. O mesmo limite vale para os recursos de CSS e JavaScript referenciados no HTML. Em páginas com HTML inflado (JSON gigante embutido, CSS inline pesado), conteúdo abaixo do corte pode nunca ser considerado. Verifique o peso do HTML bruto, descomprimido, quando páginas longas perdem partes da indexação. Valor conferido na documentação em outubro de 2026.
O que é renderizar, e por que isso importa?
Renderizar é o Google executar o código da página, como um navegador faria, para ver o conteúdo final. A documentação explica que, durante o rastreamento, o Google renderiza a página e executa o JavaScript que encontra usando uma versão recente do Chrome. Isso importa porque muitos sites só mostram o texto depois que o JavaScript roda.
Segundo o guia de SEO para JavaScript, páginas com status 200 entram numa fila de renderização, onde "podem ficar por alguns segundos, mas pode demorar mais". A mesma fonte recomenda renderização no servidor ou pré-renderização, porque deixa o site mais rápido para usuários e robôs e porque nem todo robô executa JavaScript. Sobre como os assistentes de IA buscam informação, veja como LLMs buscam, RAG e grounding.
Em linguagem simples: é como montar um móvel. O Google recebe a caixa (o HTML) e as instruções (o JavaScript) e só sabe como o móvel fica depois de montá-lo. Se a montagem demora ou falha, o catálogo guarda uma versão incompleta.
Para quem não programa: o texto principal e os links importantes devem estar no HTML que o servidor entrega.
O que é indexar?
Indexar é o Google analisar o conteúdo da página (texto, imagens, vídeos, tags importantes) e guardá-lo no índice. Nessa etapa ele também identifica páginas duplicadas e escolhe uma versão "canônica", a que ele considera principal para mostrar nos resultados.
A documentação do Google diz com todas as letras: a indexação não é garantida, e nem toda página processada será indexada. Entre os motivos citados estão conteúdo de baixa qualidade, regras de robots meta que bloqueiam a indexação e arquitetura de site difícil de processar.
Duas distinções ajudam a evitar confusões comuns:
- Rastreada não é o mesmo que indexada. O Google pode visitar a página e decidir não guardá-la.
- Indexada não é o mesmo que bem posicionada. Uma página pode estar no índice e nunca aparecer nas primeiras páginas de resultados.
Para quem já trabalha com SEO: a escolha da canônica é uma decisão do Google baseada em sinais, não uma ordem. Redirecionamentos e
rel="canonical"são sinais fortes, e a presença no sitemap é um sinal fraco, de acordo com a documentação de consolidação de URLs duplicadas. Quando o relatório indica que o Google escolheu uma canônica diferente da que você declarou, ele está dizendo que seus sinais se contradizem. O assunto continua em SEO técnico básico.
Como o Google decide a ordem dos resultados?
Quando alguém pesquisa, o Google consulta o índice e retorna as páginas que considera mais relevantes e úteis para aquela pessoa, usando centenas de sinais, entre eles localização, idioma e tipo de dispositivo. O processo é programático, e nenhum pagamento muda a posição.
Isso reforça duas ideias. Primeiro, a mesma busca pode mostrar resultados diferentes para pessoas diferentes, então "minha posição" é sempre uma média. Segundo, a página mais relevante não precisa ser a mais bonita ou rápida: a documentação de experiência na página diz que o Google sempre tenta mostrar o conteúdo mais relevante, mesmo quando a experiência é fraca. Mas, em consultas com muita oferta de conteúdo útil, boa experiência pode fazer diferença. Velocidade e estabilidade são medidas pelos Core Web Vitals.
Os resultados de IA seguem a mesma porta de entrada. O Google afirma que, para ser exibida como link de apoio em AI Overviews e AI Mode, a página precisa estar indexada e elegível para snippet (veja como otimizar para AI Overviews). Sem as duas primeiras etapas, não há terceira.
Por que minha página não aparece no Google?
A página não aparece porque parou em alguma etapa: o Google não a descobriu, não conseguiu acessá-la, a descobriu mas decidiu não indexar, ou a indexou e ela não é relevante o bastante para aparecer em posições visíveis. O relatório de indexação do Search Console indica em qual etapa ela parou.
A tabela abaixo reúne os status mais comuns, com definições baseadas na ajuda do relatório de indexação de páginas. Os nomes em português podem variar conforme a interface.
| Status (nome em inglês) | O que significa | O que fazer |
|---|---|---|
| Discovered - currently not indexed | O Google achou a URL, mas ainda não a rastreou | Aguarde; reforce links internos para a página e confirme que o servidor responde bem |
| Crawled - currently not indexed | O Google rastreou e não indexou, podendo indexar no futuro | Melhore a utilidade e a singularidade do conteúdo; evite páginas quase iguais |
| Excluded by noindex tag | O Google encontrou noindex e, por isso, não indexou | Remova o noindex se a exclusão não foi intencional |
| Blocked by robots.txt | O robots.txt impede o rastreamento da URL | Ajuste a regra de Disallow se a página deve ser rastreada |
| Duplicate without user-selected canonical | A página é duplicada de outra e você não indicou a canônica | Defina o rel="canonical" para a versão preferida |
Como diagnosticar, passo a passo?
O diagnóstico mais rápido usa a Inspeção de URL do Search Console: ela mostra se a URL está no índice, quando foi rastreada pela última vez e qual canônica o Google escolheu. Siga esta ordem:
- Abra o Search Console e cole a URL na barra de inspeção no topo.
- Leia o veredito. "URL está no Google" significa indexada. Caso contrário, anote o motivo informado.
- Compare com o teste ao vivo. A página indexada reflete a última visita do Google, que pode ser diferente da versão atual do site. O teste ao vivo mostra o que o Googlebot vê agora.
- Procure bloqueios. Verifique se há
noindexna página ou no cabeçalho HTTP e se o robots.txt bloqueia a URL. - Verifique a canônica. Veja se o "Google escolheu como canônica" é a URL que você quer.
- Reforce a descoberta. Inclua a URL no sitemap e adicione links de páginas relevantes e já indexadas.
- Peça a indexação. Use "Solicitar indexação". Segundo a documentação da ferramenta, o pedido não garante que a página entre no índice, há um limite diário de envios e a indexação costuma levar cerca de um dia, mas pode demorar bem mais.
Para quem já trabalha com SEO: a Inspeção de URL não considera todos os requisitos para aparecer, como ações manuais, problemas de segurança ou conformidade com as políticas, de acordo com a própria ajuda do Google. Um "URL está no Google" não é prova de visibilidade. Cruze com o relatório de desempenho: sem impressões para nenhuma consulta, a página está indexada, mas não está sendo exibida.
Exemplo hipotético: o post que sumiu
Exemplo hipotético: uma clínica odontológica publica na segunda-feira o artigo "Clareamento dental caseiro funciona?". Na terça, a recepcionista digita o título exato no Google e não encontra a página. Ela conclui que "o Google não gosta do site". Não é bem assim.
Antes de qualquer ajuste de texto, ela abre a Inspeção de URL. O resultado informa "Descoberta, mas ainda não indexada". A página é nova, e o site tem poucos links internos que levam até ela. A clínica então faz três ações simples: adiciona o link do artigo na página de serviços de clareamento, confirma que a URL está no sitemap e solicita a indexação. Passado um tempo razoável, ela repete a inspeção.
Ela não reescreveu o texto nem comprou links: o diagnóstico apontou a etapa certa (descoberta) e a ação foi proporcional. Se, semanas depois, o status virasse "Rastreada: atualmente não indexada", aí sim valeria rever a utilidade do conteúdo.
Perguntas frequentes
Qual a diferença entre rastrear e indexar?
Rastrear é o Googlebot visitar a URL e baixar o conteúdo. Indexar é analisar esse conteúdo e guardá-lo no índice para que possa aparecer em buscas. Uma página pode ser rastreada e não indexada, por exemplo por baixa qualidade ou por uma tag noindex.
Quanto tempo o Google leva para indexar uma página nova?
Não há prazo fixo. Na ajuda da Inspeção de URL, o Google diz que a indexação costuma levar cerca de um dia, mas que pode demorar bem mais em alguns casos. Fatores como o ritmo de rastreamento do site e os links internos para a página influenciam.
O Google ranqueia por pagamento?
Não. A documentação oficial afirma que o Google não aceita pagamento para rastrear um site com mais frequência nem para ranqueá-lo acima de outros, e que o ranqueamento é programático. Anúncios existem, mas aparecem separados e marcados, sem influência sobre os resultados orgânicos.
Minha página está indexada, mas não aparece. E agora?
Indexada só quer dizer que está no catálogo. Para aparecer, ela precisa ser relevante e competitiva para a busca. Confira no relatório de desempenho se há impressões, revise a intenção de busca e compare seu conteúdo com as páginas que já ocupam as primeiras posições.
Preciso me preocupar com crawl budget?
Provavelmente não. O Google descreve a otimização de orçamento de rastreamento como relevante para sites com mais de 1 milhão de páginas únicas atualizadas semanalmente, ou mais de 10.000 páginas com mudanças diárias, ou com muitas URLs em "Descoberta, mas não indexada". Segundo o guia sobre crawl budget, os valores são estimativas.
Próximo passo
Agora que você sabe em que etapa uma página pode falhar, o próximo guia da trilha é o de SEO técnico para quem não é programador, que explica robots.txt, sitemap, canonical e noindex, além do que pedir ao desenvolvedor. Se você usa a Contentor, a página de Resultados reúne os dados do Search Console por projeto, o que ajuda a acompanhar impressões e cliques das páginas que acabou de publicar.
Leia também:
Prepare seu conteúdo para respostas de IA
Crie briefings AEO/GEO, entidades, schema e artigos estruturados para Google AI Overviews, AI Mode e SEO tradicional.
Testar o Contentor grátisFortaleça sua autoridade para AI Search
Combine conteúdo citável com backlinks contextuais em sites verificados para reforçar confiança, descoberta e autoridade temática.
Ver backlinks contextuais